온라인 패널 조사의 응답에도 사람 대신 AI가 답한 응답이 섞일 수 있습니다. 2026년 10월 발표된 연구에서는 온라인 조사 플랫폼 7곳의 응답 중 AI 판별 테스트에 걸린 비율이 플랫폼마다 6~41%로 크게 달랐습니다.
그래서 「가상 응답자는 가짜, 사람 패널은 진짜」라는 구도로 보면 안 됩니다. 어느 쪽이든 무엇을 확인했는지 물어야 합니다.
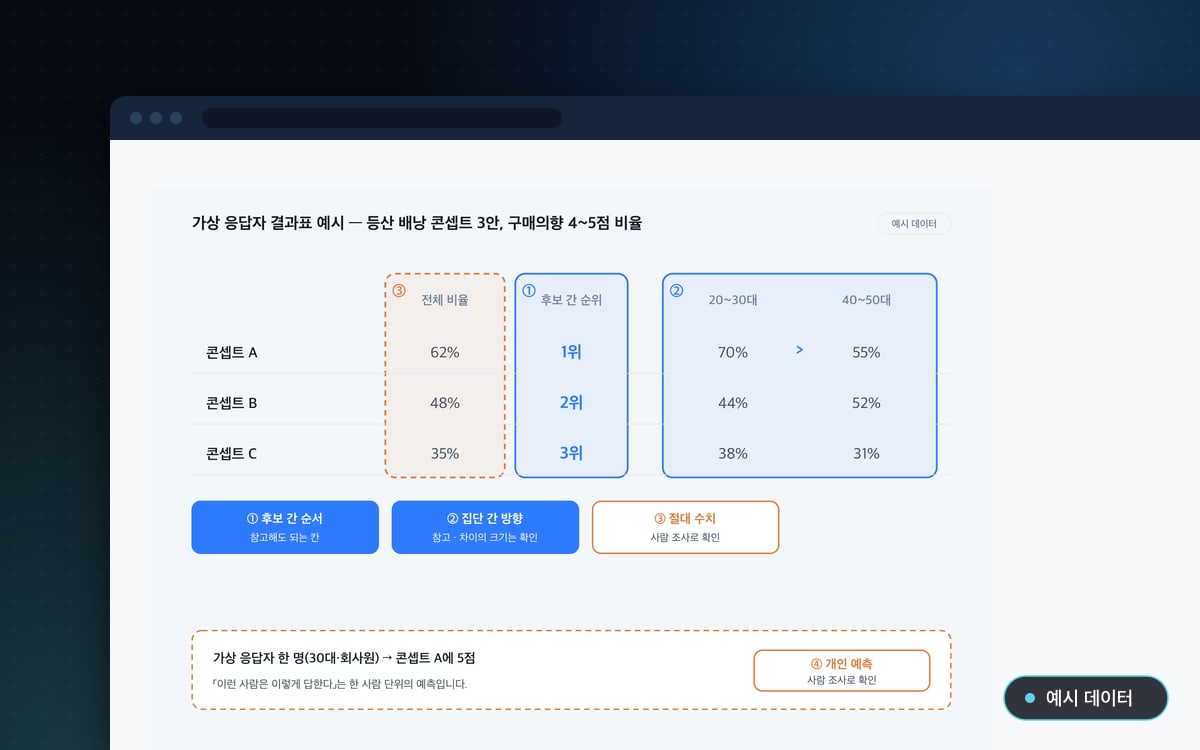
가상 응답자는 후보 비교와 가설 탐색에 쓰고, 결론은 응답 품질을 점검한 사람 조사로 확인하세요.
온라인 설문 응답자, 모두 사람일까
온라인 패널 조사는 조사 업체가 모아 둔 응답자 패널에 설문을 보내고 답을 받는 방식입니다. 빠르고 비용이 낮아서 시장조사와 학술 연구 모두에서 널리 씁니다. 지금까지 이 방식의 품질 문제는 주로 「대충 답하는 사람」이었습니다. 문항을 읽지 않고 같은 번호만 누르거나, 보상만 받고 빠지는 응답자를 걸러 내는 일입니다.
이제 걱정이 하나 더 생겼습니다. 사람이 아니라 AI 에이전트가 설문에 답하는 경우입니다. 언어모델이 문항을 읽고 그럴듯한 답을 써서 설문을 끝까지 진행할 수 있다는 우려입니다. 그렇다면 실제로 얼마나 섞여 있을까요?
2026년 10월 미국 국립과학원회보(PNAS)에 실린 연구가 이 질문을 직접 다뤘습니다(Zhang 외, 2026). 논문 초록에 따르면 연구진은 다음 순서로 확인했습니다.
먼저 AI 판별 테스트 묶음을 만들고, 신원이 확인된 사람 참가자와 AI 에이전트(상용 AI에 지시한 것, 설문용으로 만든 것)를 이 테스트가 구분하는지 검증했습니다.
이 테스트를 넣은 설문을 온라인 조사 플랫폼 7곳에서 돌렸습니다. AI 테스트에 걸린 응답자 비율은 플랫폼마다 6%에서 41%까지 차이가 났습니다.
같은 테스트에서 대면으로 참여한 사람이 잘못 걸린 비율은 2.4% 였습니다.
걸러지지 않은 AI 응답이 조사 결과를 바꿀 수 있다는 점도 보였습니다. 한편 AI 응답 비율이 낮은 플랫폼도 있었습니다.
연구진은 AI 판별 테스트와, 한 번이 아니라 꾸준히 이어지는 데이터 품질 점검이 시급하다고 결론지었습니다. 이 글은 논문의 초록을 근거로 정리했습니다. 판별 테스트의 세부 문항과 플랫폼별 결과는 원문을 참고하세요.
왜 문제인가 — 비교의 기준이 흔들린다
AI 응답이 섞이면 결과가 어떻게 달라질까요? 가상 응답 연구들은 언어모델의 답이 평균은 그럴듯해도 응답의 퍼짐이 실제보다 좁고, 특정 방향으로 쏠릴 수 있다고 보고해 왔습니다(Bisbee 외, 2024 등. AI 설문조사, 써도 되는 때와 쓰면 안 되는 때에서 정리했습니다). 그런 응답이 사람 패널 안에 섞이면 사람 조사 결과도 같은 방향으로 기울 수 있습니다.
더 큰 문제는 비교의 기준입니다. 가상 응답자의 결과가 얼마나 믿을 만한지는 보통 같은 문항의 사람 조사 결과와 맞춰 보고 판단합니다. 그런데 그 사람 조사에 AI 응답이 섞여 있다면, 「가상 응답과 사람 응답이 비슷하다」는 결과가 무엇을 뜻하는지 알 수 없게 됩니다. 기준이 되는 쪽부터 확인해야 하는 이유입니다.
조사 업체에 물어볼 7가지
온라인 패널 조사를 맡기기 전에 아래 질문을 해 보세요. 모든 항목에 「예」가 나와야 하는 것은 아닙니다. 다만 어떤 점검을 하고 어떤 점검은 하지 않는지 알고 맡기는 것과 모르고 맡기는 것은 다릅니다.
AI 응답 판별을 하나요? 한다면 무엇을 점검하는지(문항 안의 판별 장치, 응답 행동, 응답 내용 등) 설명을 들을 수 있나요?
응답자 본인 확인은 언제, 어떻게 하나요? 패널 가입 때 한 번만 하는지, 그 뒤에도 주기적으로 다시 하는지 확인합니다.
이번 조사에서 걸러진 응답 수를 알려 주나요? 프로젝트마다 걸러진 수와 사유를 보고받을 수 있는지 묻습니다.
걸러진 응답은 어떻게 처리하나요? 표본을 다시 채워 주는지, 그 비용은 누가 내는지 미리 정합니다.
판별 기준이 사람을 잘못 거르는 경우도 따져 봤나요? 너무 엄격한 기준은 특정 연령층이나 응답 습관을 가진 사람을 함께 걸러 표본을 기울게 할 수 있습니다.
점검을 계속 고치고 있나요? AI 도구가 빠르게 바뀌므로, 한 번 만든 기준을 그대로 쓰는지 주기적으로 다시 점검하는지 묻습니다.
원자료에 품질 정보를 함께 주나요? 응답 시간, 판별 결과 표시 같은 정보가 있으면 의뢰한 쪽에서 다시 검토할 수 있습니다.
업체 답변과 별개로, 설문을 만드는 쪽에서 할 수 있는 점검도 있습니다. 문항을 제대로 읽었는지 확인하는 질문을 넣고, 같은 내용을 다른 표현으로 한 번 더 묻고, 열린 문항의 답을 직접 읽어 보고, 응답 시간 분포를 확인하는 것입니다. 모두 예전부터 쓰던 응답 품질 점검이지만, AI 응답이 섞일 수 있다는 전제로 다시 볼 필요가 있습니다.
가상 응답자와 사람 조사, 역할 나누기
사람 조사도 검증이 필요하다는 말이 가상 응답자로 사람 조사를 대신하자는 뜻은 아닙니다. 두 방법은 잘하는 일이 다르고, 순서를 정해 함께 쓸 때 쓸모가 큽니다.
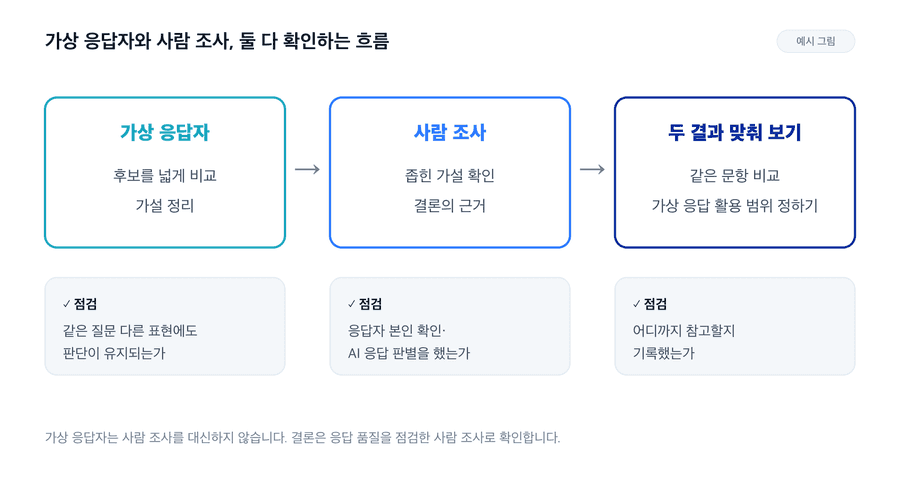
가상 응답자와 사람 조사를 나눠 쓰는 흐름. 양쪽 모두에 점검 단계가 있습니다. (예시 그림)
가상 응답자로 넓게 비교하기 — 콘셉트 후보, 가격 조건, 소비자층을 넓게 놓고 반응의 방향과 차이를 봅니다. 사람 조사로는 비용 때문에 다 묻기 어려운 범위를 미리 훑는 단계입니다.
가설 정리하기 — 반응이 갈린 지점과 이유를 가설로 적습니다. 「이 소비자층은 가격보다 무게에 민감할 것이다」 같은 형태입니다.
사람 조사 설계하기 — 가설을 확인할 대상과 문항을 정합니다. 이때 위의 7가지 질문으로 응답 품질 점검 조건도 함께 정합니다.
사람 조사로 결론 확인하기 — 점검을 거친 사람 응답으로 가설이 맞는지 판단합니다. 결론의 근거는 이 단계입니다.
두 결과 맞춰 보기 — 같은 문항의 가상 응답과 사람 응답을 비교해, 다음에 가상 응답 결과를 어디까지 참고할지 정합니다.
가상 응답자 쪽에도 점검이 필요합니다. 같은 질문을 표현만 바꿔 물었을 때 같은 응답자의 판단이 유지되는지 같은 점검입니다. 이 문제는 합성 페르소나 설문의 응답 일관성 글에서 다뤘습니다. 디지털 트윈 실험실이 같은 조사를 실제 사람에게도 실시해 AI 조사 결과와 비교하는 절차를 설계에 넣은 것도, 가상 응답과 사람 응답 모두를 확인 대상으로 보기 때문입니다.
한계와 주의할 점
한 연구의 결과입니다. 위 수치는 한 연구에서 온라인 플랫폼 7곳을 조사한 결과입니다. 다른 패널이나 다른 시기에 그대로 옮길 수 없고, 국내 패널의 수준도 이 연구로는 알 수 없습니다.
판별 테스트도 틀릴 수 있습니다. 대면 참가자도 일부가 잘못 걸렸습니다. 「걸렸다 = AI」로 단정하지 말고, 판별 결과를 응답 품질 판단의 한 가지 근거로 쓰세요.
업체 이름보다 프로젝트마다 확인하세요. 플랫폼마다 차이가 컸으므로, 업체 평판보다 이번 조사에서 어떤 점검을 했는지를 확인하세요.
가상 응답자는 사람 조사를 대신하지 않습니다. 가상 응답자는 사람 조사를 언제, 누구에게, 무엇을 물을지 정하는 데 쓰는 도구입니다. 그리고 그 사람 조사도 응답 품질을 점검했을 때 결론의 근거가 됩니다.
다음 단계
본조사 전에 후보 콘셉트와 문항을 가상 응답자로 먼저 훑어보고, 사람 조사에서 확인할 가설을 좁히고 싶다면 문의해 주세요.
Bisbee, J., Clinton, J. D., Dorff, C., Kenkel, B., & Larson, J. M. (2024). Synthetic replacements for human survey data? The perils of large language models. Political Analysis, 32(4), 401–416. doi:10.1017/pan.2024.5
Zhang, G., Walatka, R., Chen, S. Y., Moore, A. K., Urminsky, O., Fernandez, K., Low, A., Bogard, J. E., & Fox, C. R. (2026). Estimating the threat of AI-agent responding across online survey platforms. Proceedings of the National Academy of Sciences, 123(42), e2606460123. doi:10.1073/pnas.2606460123
가상 인물 데이터의 출처는 NVIDIA Nemotron-Personas(CC BY 4.0)입니다.
FOR RESEARCHERS
조사·연구 설계에 가상 응답자를 써 보려면
파일럿 단계의 문항 점검, 조건 비교, 표본 할당 검토에 어떻게 쓸 수 있는지 연구 목적 활용 방법을 안내해 드립니다.