AI 설문조사는 사람 조사를 대신하는 도구가 아니라, 사람 조사를 언제, 누구에게 할지 정하는 도구로 쓸 때 가장 쓸모가 있습니다.
문항 점검, 조건 비교, 조사 대상 좁히기에는 맡길 만합니다. 최종 수요 추정, 소수 집단의 세밀한 판단, 고위험 결정은 맡기면 안 됩니다.
가상 응답 → 사람 조사 → 둘의 비교라는 순서를 지키면, AI 결과를 어디까지 믿을지 스스로 판단할 수 있습니다.
AI 설문조사, 지금 어디까지 왔나
AI 설문조사는 대규모 언어모델(LLM)로 만든 가상 응답자에게 설문을 하고 그 답을 분석하는 방식입니다. 「합성 응답자」 「가상 소비자」 「실리콘 샘플」 등 부르는 이름은 여러 가지지만 생각은 같습니다. 사람을 모으기 전에, 사람처럼 답하는 모델에게 먼저 물어보자는 것입니다.
이 생각은 학계에서 먼저 주목받았습니다. 인구통계 조건을 준 언어모델의 응답이 실제 집단의 응답 경향과 상당 부분 닮을 수 있다는 연구(Argyle 외, 2023)가 나온 뒤, 고전적인 사람 대상 실험을 가상 응답자로 재현해 보는 시도도 이어졌습니다(Aher 외, 2023).
반대 방향의 결과도 함께 쌓였습니다. 가상 응답은 평균은 그럴듯해도 응답의 퍼짐이 실제보다 좁고, 질문 문구를 조금만 바꿔도 응답 분포가 달라진다는 연구가 있습니다(Bisbee 외, 2024). 모델이 내는 의견이 특정 집단의 의견 쪽으로 쏠린다는 연구도 있습니다(Santurkar 외, 2023).
두 흐름을 함께 보면 결론은 비교적 분명합니다. 가상 응답자는 쓸 곳이 있는 도구이지만, 사람 조사의 대체물로 쓰면 위험한 도구입니다. 그렇다면 어디에 쓰고 어디에 쓰지 말아야 할까요?
가상 응답자가 잘하는 일
가상 응답자는 「정답」을 내기보다 비교와 점검에 강합니다. 실무와 연구에서 쓸 만한 일은 크게 세 가지입니다.
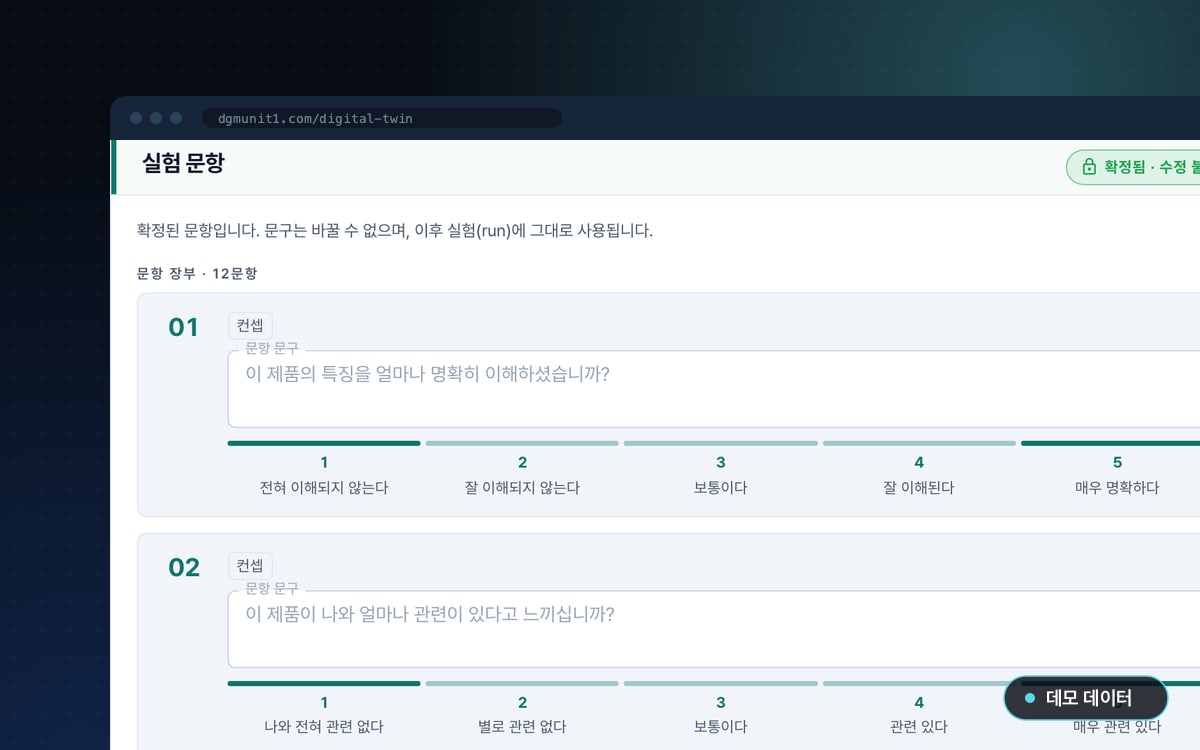
① 문항 점검. 본 조사 전에 문항을 가상 응답자에게 먼저 보여 주면, 이해하기 어려운 문구나 보기 순서에 따라 답이 쏠리는 문항을 미리 찾을 수 있습니다. 문항 하나를 잘못 써서 본 조사를 다시 하는 비용에 비하면 값싼 점검입니다.
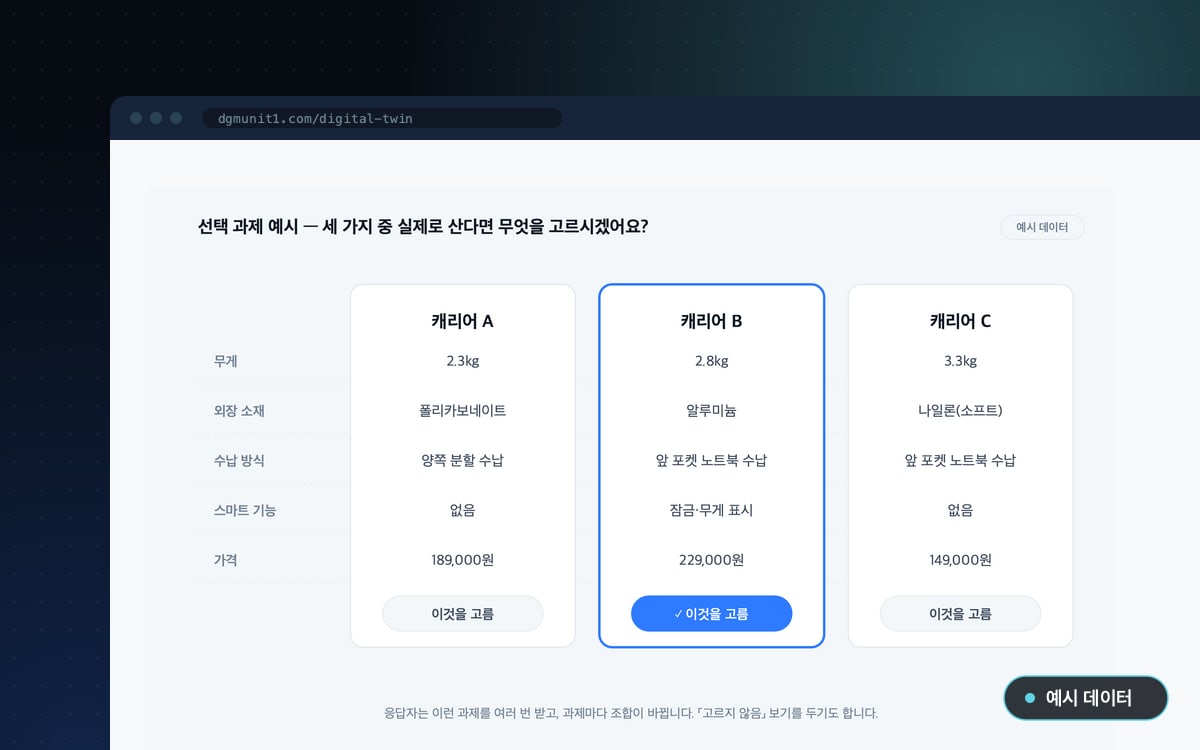
② 조건 비교. 콘셉트 A와 B, 가격 조건 하나만 바꾼 두 안처럼 조건 하나만 다른 상황을 같은 응답자 그룹에 물어 반응의 방향을 봅니다. 절대 점수보다 차이와 방향을 보는 일이므로, 가상 응답자를 쓰기에 상대적으로 무리가 적은 용도입니다.
③ 조사 대상 좁히기. 여러 나라, 여러 소비자층에 같은 질문을 던져 반응이 크게 갈리는 지점을 찾습니다. 그 지점이 실제 조사에서 표본을 더 배정해야 할 곳입니다.
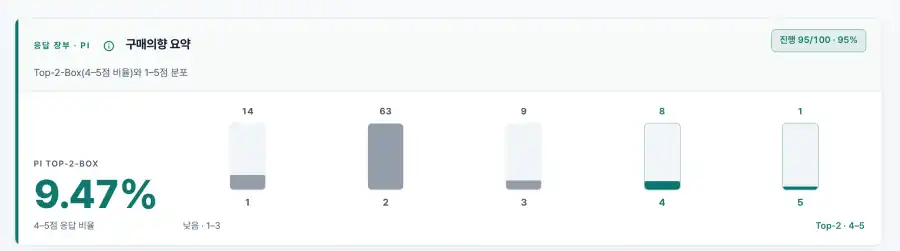
조건 비교에 쓰는 구매의향 요약 화면 예시. 콘셉트·가격 조건을 바꿔 같은 문항으로 다시 묻고 분포를 비교합니다. (가상 데이터, 데모 데이터)
맡기면 안 되는 일
반대로 아래 일은 가상 응답자에게 맡기지 않는 것이 좋습니다.
쓸 때
쓰지 않을 때
본 조사 전 문항 이해도·보기 순서 점검
최종 수요·매출 추정
콘셉트·가격 조건을 바꾼 비교(방향 보기)
「이 정도 비율이 산다」 같은 절대 수치 판단
반응이 갈리는 국가·소비자층 찾기
표본이 작은 소수 집단의 세밀한 판단
파일럿 조사, 표본 설계 검토
정책·의료 같은 고위험 결정의 근거
실제 조사 대상·문항 정하기
「실제 사람의 의견을 대표한다」는 주장
가장 흔한 실수는 오른쪽 칸의 첫 줄입니다. 가상 응답자의 구매의향 비율을 그대로 시장 규모 추정에 넣는 것입니다. 앞서 본 연구들처럼 가상 응답은 퍼짐이 좁고 특정 방향으로 쏠릴 수 있습니다. 비율 자체보다 조건 사이의 차이를 보는 데 써야 합니다.
사람 조사와 함께 쓰는 순서
가상 응답자를 쓰는 가장 안전한 방법은 사람 조사의 앞과 뒤에 함께 두는 것입니다.
가상 응답으로 먼저 묻기 — 후보 콘셉트·조건·대상을 넓게 놓고 가상 응답자에게 묻습니다.
반응이 갈린 지점 확인 — 어떤 콘셉트, 어떤 소비자층에서 반응이 갈렸는지 봅니다.
사람 조사 설계 — 갈린 지점을 중심으로 실제 조사의 대상과 문항을 정합니다.
같은 조사를 사람에게 — 가능하면 가상 응답에 쓴 문항과 같은 문항으로 실제 조사를 합니다.
둘을 비교해 신뢰 범위 정하기 — AI 결과와 사람 조사 결과를 맞춰 보고, AI 결과를 어디까지 믿을지 판단합니다.
5단계가 빠지면 가상 응답의 결과를 얼마나 믿어야 할지 알 수 없습니다. 디지털 트윈 실험실이 같은 조사를 실제 사람에게도 실시해 AI 조사 결과와 비교하고, AI 결과를 얼마나 믿을 수 있는지 판정·보정하는 절차를 설계에 넣은 것도 이 때문입니다. 이 접근과 특허 출원 내용은 합성 페르소나 설문의 응답 일관성 글에 정리했습니다.
연구자·리서처용 파일럿 체크리스트
논문용 설문 실험이나 시장조사 본조사를 앞두고 가상 응답자로 파일럿을 돌린다면, 아래 항목을 확인해 보세요.
문항 이해도 — 가상 응답자가 문항을 의도와 다르게 읽은 흔적이 없는가
표현·순서 바꿔 다시 묻기 — 같은 문항을 표현·보기 순서만 바꿔 물었을 때 같은 응답자의 판단이 유지되는가
조건 하나만 바꾸기 — 가격처럼 한 조건만 바꿨을 때 답이 예상한 방향으로 움직이는가
굳은 응답자 걸러 보기 — 어떤 조건에서도 늘 같은 답을 내는 응답자는 일관된 것이 아니라 굳어 있는 것이다
퍼짐 확인 — 응답 분포가 지나치게 한 점수에 몰려 있지 않은가
모델이 바뀌면 다시 점검 — 응답을 만드는 모델이나 설정이 바뀌었다면 같은 점검을 다시 했는가
사람 조사와의 비교 계획 — 본조사 결과와 가상 응답을 어떤 문항으로 맞춰 볼지 정했는가
이 점검은 전통적인 문항 사전 점검을 대신하지 않습니다. 인지 인터뷰, 전문가 검토, 소규모 사전 조사 같은 방법(Presser 외, 2004)과 나란히 쓰는 것이 좋습니다. 가상 응답자는 이런 방법을 시작하기 전에 문제가 큰 문항을 미리 걸러 내는 데 유용합니다.
가상 인물 데이터는 어디서 오나 — 합성 인구 데이터의 의미와 한계
가상 응답자의 「인물 설정」은 어디서 올까요? 디지털 트윈 실험실은 NVIDIA가 국가별 인구통계 분포를 반영해 만들어 공개한 합성 인구 데이터셋 Nemotron-Personas(한국 데이터셋 예)를 기반으로, 10개국 1,000만 건 규모의 가상 인물 데이터를 응답자 표본으로 씁니다. 연령·성별·지역·직업 조건으로 응답자 그룹을 구성할 수 있습니다.
이런 합성 인구 데이터에는 두 가지 의미가 있습니다.
실존 인물의 개인정보를 다루지 않습니다. 실제 사람의 정보가 아니라 통계 분포에 맞춰 만든 합성 데이터입니다.
분포를 따릅니다. 국가별 연령·성별·지역·직업 분포를 반영하므로, 표본 구성을 실제 인구와 비슷하게 맞출 수 있습니다.
한계도 분명합니다. 분포를 따른다고 해서 그 사람들의 실제 의견을 담고 있는 것은 아닙니다. 인물 설정은 인구통계의 틀일 뿐, 답의 내용은 모델이 만듭니다. 그래서 다시 한 번, 가상 응답자의 결과는 사람 조사와 맞춰 볼 때 의미가 생깁니다.
다음 단계
설문 실험이나 본조사를 앞두고 문항과 조건을 미리 점검하고 싶다면, 가상 응답자로 파일럿을 먼저 돌려 보세요.
Argyle, L. P., Busby, E. C., Fulda, N., Gubler, J. R., Rytting, C., & Wingate, D. (2023). Out of one, many: Using language models to simulate human samples. Political Analysis, 31(3), 337–351. doi:10.1017/pan.2023.2
Aher, G., Arriaga, R. I., & Kalai, A. T. (2023). Using large language models to simulate multiple humans and replicate human subject studies. Proceedings of the 40th International Conference on Machine Learning (ICML 2023), PMLR 202, 337–371. proceedings.mlr.press/v202/aher23a
Bisbee, J., Clinton, J. D., Dorff, C., Kenkel, B., & Larson, J. M. (2024). Synthetic replacements for human survey data? The perils of large language models. Political Analysis, 32(4), 401–416. doi:10.1017/pan.2024.5
Santurkar, S., Durmus, E., Ladhak, F., Lee, C., Liang, P., & Hashimoto, T. (2023). Whose opinions do language models reflect? Proceedings of the 40th International Conference on Machine Learning (ICML 2023), PMLR 202, 29971–30004. proceedings.mlr.press/v202/santurkar23a
Presser, S., Couper, M. P., Lessler, J. T., Martin, E., Martin, J., Rothgeb, J. M., & Singer, E. (2004). Methods for testing and evaluating survey questions. Public Opinion Quarterly, 68(1), 109–130. doi:10.1093/poq/nfh008
가상 인물 데이터의 출처는 NVIDIA Nemotron-Personas(CC BY 4.0)입니다.
FOR RESEARCHERS
조사·연구 설계에 가상 응답자를 써 보려면
파일럿 단계의 문항 점검, 조건 비교, 표본 할당 검토에 어떻게 쓸 수 있는지 연구 목적 활용 방법을 안내해 드립니다.